Zum Inhalt springen
Verinity

Labor

Woran wir gerade arbeiten

Im Labor zeigen wir eigene Vorhaben und technische Entwicklungen von Verinity. Einige Bausteine nutzen wir bereits im eigenen Betrieb, andere befinden sich noch im Aufbau.

Der rote Faden durch alles hier ist derselbe: Daten sollen das eigene Umfeld nicht verlassen müssen, nur weil eine Funktion gebraucht wird.

Hinweis
Auf dieser Seite steht bewusst Unfertiges. Jeder Punkt trägt seinen Status. Was produktiv im Einsatz ist, steht auf der Referenzseite.

01 — Thema

Eine Plattform für den Arbeitsalltag von Organisationen

In Entwicklung · noch nicht buchbar

Kontakte, Vorgänge, Aufgaben, Dokumente und Kommunikation in einem gemeinsamen Arbeitsbereich — im Browser, für unterschiedliche Organisationsstrukturen. In Entwicklung, noch nicht buchbar.

Stand: Die Plattform befindet sich in Entwicklung. Das technische Fundament und die Trennung der Organisationen sind umgesetzt und geprüft. Derzeit arbeiten wir an der Protokollierung und den Datenschutzabläufen. Anschließend folgen die fachlichen Funktionen und die Erprobung im täglichen Betrieb einer ersten Organisation. Ein produktiver Pilotbetrieb hat noch nicht begonnen; die Plattform ist noch nicht buchbar.

Verinity entwickelt eine modulare SaaS-Plattform, die Kontakte, Vorgänge, Aufgaben, Dokumente und Kommunikation in einem gemeinsamen Arbeitsbereich zusammenführt. Im Browser zugänglich und auf unterschiedliche Organisationsstrukturen ausgelegt. Damit Informationen zusammenbleiben, Zuständigkeiten klar sind und die nächsten Schritte sichtbar werden.

Für die erste Version stehen die täglichen Arbeitsabläufe im Mittelpunkt: Personen, Unternehmen und Ansprechpartner verwalten, Vorgänge bearbeiten, Aufgaben zuweisen und Fristen verfolgen. Dokumente, Fotos und Notizen werden direkt dem jeweiligen Kontakt oder Vorgang zugeordnet. Bestehende Daten sollen sich aus Tabellen übernehmen lassen. Eine ergänzende mobile App ist für Aufgaben unterwegs vorgesehen.

Die zentrale Arbeitsübersicht soll zeigen, wo Handlungsbedarf besteht: überfällige Aufgaben, Vorgänge ohne Verantwortliche oder fehlende Unterlagen. Jeder Eintrag führt zum betreffenden Datensatz. Wird die Aufgabe dort erledigt, aktualisiert sich auch die Übersicht. So bleibt der Bearbeitungsstand für alle Beteiligten nachvollziehbar.

Organisationen unterscheiden sich in ihren Begriffen, Zuständigkeiten und Abläufen. Deshalb entsteht die Plattform auf einer gemeinsamen Grundlage mit konfigurierbaren Modulen, Feldern, Rollen und Ablaufvorlagen. Darauf sollen schrittweise Funktionspakete für unterschiedliche Einsatzbereiche aufbauen. Auch die persönliche Arbeitsansicht soll sich anpassen lassen: mit eigenen Filtern, gespeicherten Ansichten und Favoriten. Jede Organisation soll ihren eigenen Auftritt mit Namen, Logo und auf Wunsch eigener Internetadresse erhalten.

Der Ausbau ist gestaffelt. Auf die grundlegende Verwaltung und Vorgangsbearbeitung sollen unter anderem gemeinsame E-Mail-Bearbeitung, Kalenderansichten, Portale zur eigenständigen Datenpflege und konfigurierbare Automatisierungen folgen. Alle Bereiche sind darauf ausgelegt, dieselben Daten und Berechtigungen zu nutzen.

Der Schutz dieser Daten gehört zum Fundament. Jede Organisation erhält eine separate Datenbank. Rollen und Berechtigungen regeln den Zugriff innerhalb ihres Bereichs. Nachvollziehbare Änderungen sowie geregelte Auskunfts-, Aufbewahrungs- und Löschabläufe sind in der Architektur vorgesehen und werden derzeit umgesetzt. Dazu gehört auch, ausgeführte Löschungen nach einer Wiederherstellung aus einer Sicherung erneut anzuwenden, bevor das System wieder genutzt wird. Für Datenexporte und die Anbindung anderer Anwendungen sind dokumentierte Schnittstellen vorgesehen.

Als SaaS soll die Plattform zunächst von Verinity auf eigener Infrastruktur in Österreich betrieben, gewartet und weiterentwickelt werden. Zusätzlich ist dieselbe Software für einen separaten Betrieb auf einem gemieteten Server oder auf der Hardware einer Organisation angelegt. Diese Betriebsformen sind Teil der weiteren Planung.

Wir geben Einblick in den aktuellen Stand und besprechen, welche Anforderungen die Plattform für eine Organisation erfüllen müsste.
02 — Thema

KI auf eigener Infrastruktur

In Arbeit

Modelle im eigenen Umfeld betreiben und trainieren — aus demselben Grund, aus dem wir Geocoding selbst betreiben.

Jede Anfrage an ein KI-Modell eines fremden Anbieters trägt ihren Inhalt nach außen. Bei einer Ideensammlung ist das gleichgültig. Bei einem Schriftstück mit Namen, Adressen, Krankheits- oder Sozialdaten ist es eine Übermittlung personenbezogener Daten an einen Auftragsverarbeiter — häufig außerhalb der EU, oft mit unklarer Aussage darüber, was mit den Eingaben geschieht. An dieser Stelle endet manches KI-Vorhaben — nicht an der Technik, sondern daran, dass niemand die Datenschutzfolgenabschätzung unterschreiben will.

Bei Karten und Adresssuche stand dasselbe Problem: Jede Kartenkachel und jede Adressanfrage hätte IP-Adresse und Wohnumgebung der Nutzer an einen fremden Dienst getragen. Unsere Antwort war, den Dienst selbst zu betreiben — auf amtlicher österreichischer Datengrundlage, auf eigenem Server. Bei KI ist die Überlegung dieselbe.

Deshalb arbeiten wir daran, Modelle im eigenen Umfeld zu betreiben und für konkrete Aufgaben nachzutrainieren, statt sie allgemein zu befragen. Ein Modell, das gelernt hat, genau deine Dokumentart zu lesen, braucht weder Internetzugang noch einen Anbietervertrag — es läuft dort, wo die Daten ohnehin schon liegen. Für Organisationen mit sensiblen Beständen ist das häufig die Voraussetzung dafür, KI überhaupt einzusetzen.

Für die Plattform oben ist das als Architektur festgeschrieben. Die Regeln daraus: KI soll nie direkten Zugriff auf die Datenbank bekommen — jeder Zugriff soll über freigegebene Endpunkte laufen, die Benutzer, Organisation, Ressource und Aktion erneut prüfen. Organisationsdaten sollen nie in Modelltraining fließen, externe Modelle je Organisation abschaltbar sein, personenbezogene Angaben vor einer externen Weitergabe entfernt werden und für sensible Bestände ausschließlich lokale Modelle laufen. Rechtlich, finanziell oder operativ kritische Entscheidungen brauchen eine menschliche Freigabe.

Vorgesehen ist dazu ein eigenes KI-Protokoll: Organisation und Benutzer, Modell und Version, verwendete Quellen, Werkzeugaufrufe, Ergebnisstatus und die menschliche Freigabe. Vollständige sensible Eingaben werden dabei bewusst nicht dauerhaft gespeichert — wer wissen will, warum ein Modell etwas ausgegeben hat, kann das nachvollziehen, ohne dass das Protokoll selbst zum Datenrisiko wird.

Stand: Das ist Aufbau- und Erprobungsarbeit im eigenen Haus, keine Leistung, die wir heute ausliefern. In der Bauvorgabe unserer Plattform ist KI ausdrücklich erst für die Zeit nach dem ersten Produktivgang vorgesehen. Eine Kundenauslieferung hat es dazu bisher nicht gegeben.

03 — Thema

Datensouveränität als durchgehende Linie

Produktiv im Eigenbetrieb

Was wir empfehlen, betreiben wir selbst — Karten, Adressen, Mail und Betrieb laufen auf eigener Infrastruktur in Österreich.

Datensouveränität ist bei uns eine Betriebsentscheidung, die wir zuerst an uns selbst durchgesetzt haben. Unser eigener Server steht in einem Rechenzentrum in Wien. Darauf laufen die Geoplattform, der Mailserver samt Webmail für zwei Domains, die Vereins-Infrastruktur und die Überwachung — keiner dieser Dienste läuft bei einem US-Anbieter.

Das hat konkrete Folgen für die Systeme, die wir für andere bauen. In einem Projekt verweigert die Anwendung in Produktion sogar den Start, wenn die Adresse des Geocoding-Dienstes auf einen öffentlichen Fremdanbieter zeigt. So lässt sich die Datenschutzentscheidung nicht versehentlich aushebeln: Das System kommt dann gar nicht erst hoch.

Aus derselben Haltung stammen die kleinen Entscheidungen, die niemand sieht: Schriften hosten wir selbst, statt sie von einem fremden Netz nachzuladen. Fehlertracking betreiben wir selbst, statt es an einen Dienstleister zu geben. Und aus hochgeladenen Fotos werden Standort- und Geräteangaben entfernt, bevor sie überhaupt gespeichert werden.

Für die Plattform, die wir gerade bauen, ziehen wir diese Linie bis zur Organisation weiter: Betreibt eine Organisation sie später selbst, bleibt nicht nur die Datenbank bei ihr, sondern alles — Anwendung, Schlüssel, Dateien. Das ist festgelegte Richtung, noch kein Angebot.

04 — Thema

Tagio — eine Erfassungs-App, die absichtlich nichts entscheidet

Gebaut · Store-Einreichung offen

Codes so schnell wie möglich hintereinander scannen — Barcode, QR, Data Matrix, NFC — und jeden Scan als Zeile an eine eigene Schnittstelle schicken. Die Hoheit über Schema, Rechte und Duplikate liegt beim Server, nicht in der App.

Inventur, Preispflege, Etiketten: Überall dort wird gescannt, und überall stellt sich dieselbe Frage, wem die Daten danach gehören. Tagio ist unsere Antwort für iPhone und Android: eine App, die nichts weiß und nichts entscheidet. Sie scannt, hängt die vom Server vorgegebenen Felder an — Auswahl oder Zahl, wahlweise über mehrere Scans hinweg festgehalten — und schickt jede Erfassung als eigene Zeile an die Schnittstelle, die der Nutzer selbst einträgt. Ohne Server gibt es einen vollwertigen lokalen Modus mit CSV- und JSON-Export.

Für Tagio gilt: keine Cloud, keine Analyse- oder Absturzberichte, keine Werbe- oder Gerätekennungen. Selbstsignierte Zertifikate werden je Profil einmal bestätigt und dann festgehalten — einen Schalter „alle Zertifikate akzeptieren“ gibt es nicht, und ein Passwort steckt nie im Einrichtungs-QR-Code. Die Schnittstelle ist als offener Vertrag beschrieben, mit Dokumentation auf Deutsch und Englisch und einem Referenzserver, den jeder nachbauen kann.

Geprüft, bevor jemand sie benutzt: 156 automatisierte Tests (Stand 18.08.2026) — 71 Vertragstests gegen den Referenzserver und 85 App-Tests, darunter zwölf Integrationsszenarien für Netzausfall, Zeitüberschreitung, Profilwechsel und Zertifikatswechsel — dazu eine Prüfung, dass jede Übersetzung in beiden Sprachen vollständig ist. Ein adversariales Review mit frischem Kontext hat den Code gegen das Konzept gelesen: zwölf Befunde, einer davon kritisch, alle behoben.

Stand: Die erste Fassung ist fertig gebaut, das Android-Paket und ein unsigniertes iOS-Build bauen fehlerfrei (Stand 18.08.2026). Was noch fehlt, sind die Prüfungen am echten Gerät — NFC, Kamera, Ton — und die Einreichung in beiden Stores.

05 — Thema

Open Source: ein Terminal, das nichts verrät

Veröffentlicht · Open Source (MIT)

react-timeclock-kiosk — ein Kiosk-Terminal für Zeiterfassung per NFC, RFID und QR, dessen öffentlicher Bildschirm keine persönlichen Daten zeigt. Frei verfügbar unter MIT-Lizenz, gedacht als Baustein für die Mandanten-Plattform.

Quellcode auf GitHub

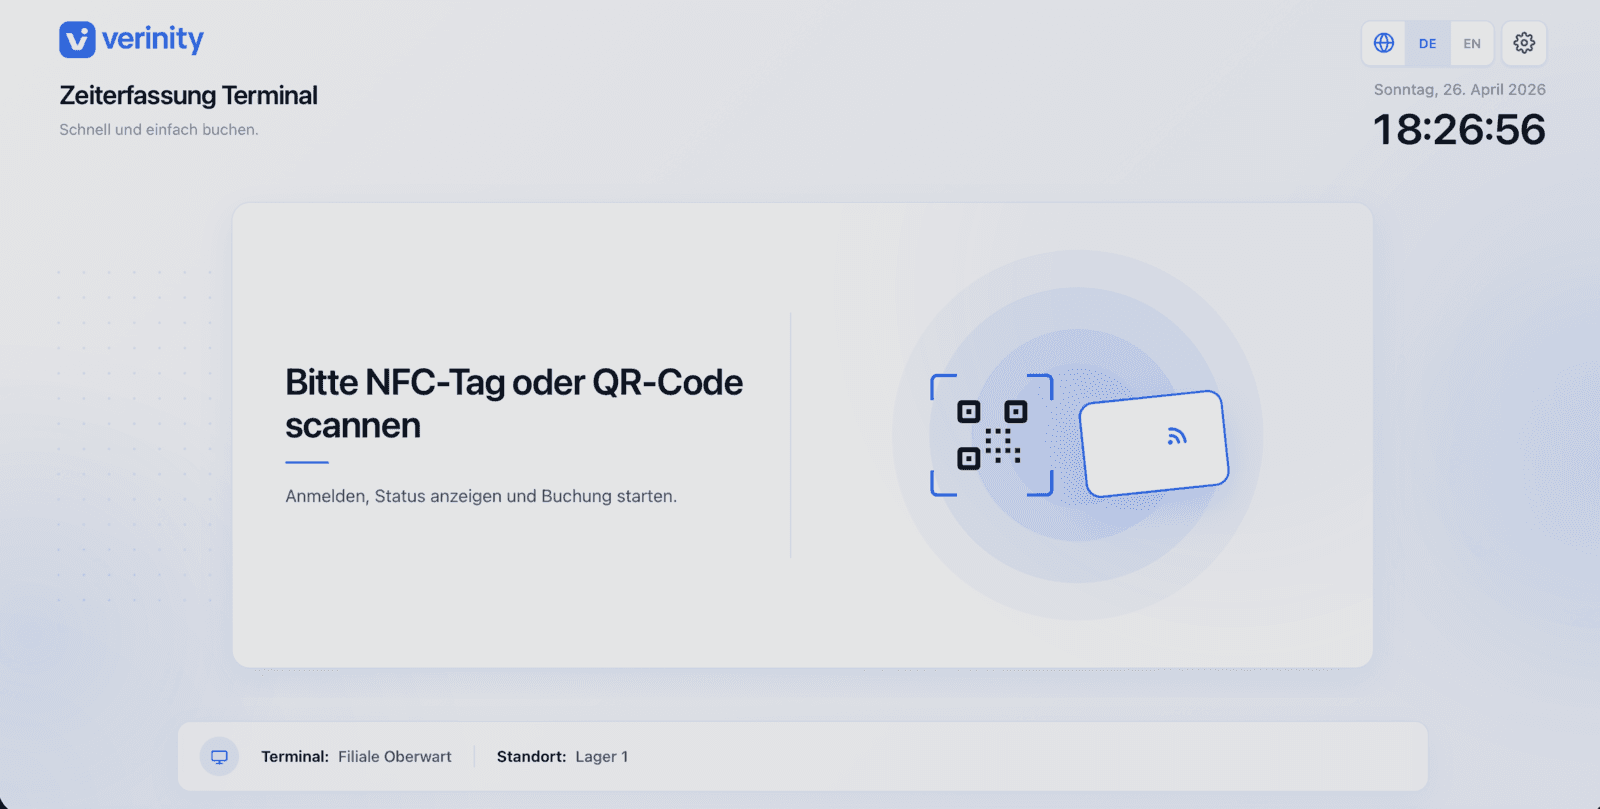
Das Terminal am Werkstatteingang ist der Teil eines Zeiterfassungssystems, den jeder Mitarbeiter mehrmals täglich sieht. Genau diesen Teil haben wir gebaut, und nur ihn: einen Ruhebildschirm mit Uhr, Datum und ständiger Scan-Bereitschaft, ohne „Scan starten“-Knopf, der ohne Backend läuft und ernst nimmt, dass dieser Bildschirm öffentlich ist.

Datenschutz durch Weglassen: Der öffentliche Bildschirm zeigt nie, wer zuletzt gestempelt hat — keine Namen, keine Avatare, keine Buchungen, keine offenen Sitzungen. Erst nach dem eigenen Scan erscheint der eigene Status, und nach der Buchung kehrt das Terminal von selbst in den Ruhezustand zurück. Die Einstellungen liegen hinter einer PIN. NFC, RFID und QR sind gleichberechtigt und einzeln abschaltbar; der Leser ist als austauschbare Schnittstelle gebaut, damit echte Hardware die Attrappe ersetzt, ohne die Oberfläche anzufassen.

Technisch bewusst klein: React 19, Vite, striktes TypeScript, Tailwind v4 — kein Router, keine Zustandsbibliothek, kein UI-Baukasten, keine Übersetzungsbibliothek; Deutsch und Englisch stecken in einem einzigen Objekt. Das fertige Bündel wiegt rund 78 Kilobyte komprimiert. Das Terminal ist als eigenständiges Modul geschnitten, das sich in jede andere React-Anwendung einsetzen lässt — genau so ist es als Baustein für unsere Mandanten-Plattform gedacht.

Stand: Das ist die Lite-Fassung — eine Demo ohne Backend, ohne echte Mitarbeiterdaten und ohne Hardwareanbindung, veröffentlicht als Open Source unter MIT-Lizenz. Was sie zeigt: Was auf einem öffentlichen Bildschirm gar nicht erst erscheint, muss man dort auch nicht schützen.

Ruhebildschirm des Zeiterfassungs-Terminals: Uhr, Datum und Scan-Bereitschaft für NFC, RFID und QR — ohne Namen, ohne Buchungen
Ruhebildschirm, Deutsch · Demo ohne Backend

06 — Thema

Mehrere eigene Projekte parallel

Erprobung

Werkzeuge und Systeme für den eigenen Bedarf — der Ort, an dem neue Fähigkeiten entstehen, bevor sie in Kundenprojekte gehen.

Neben den Systemen auf unserer Referenzseite laufen bei uns durchgehend mehrere eigene Vorhaben — Werkzeuge für den täglichen Bedarf und Erkundungen in Bereiche, die uns interessieren. Gemeinsam ist ihnen, dass sie an echten Aufgaben entstehen und nicht als Übung.

In eigenen Projekten haben wir Verfahren erprobt, die von mehrstufigen Verarbeitungsketten mit Rückfall-Ebenen über die Absicherung gegen manipulierte Eingaben bis zur quantitativen Abnahme gegen ein gemessenes Toleranzband reichen. Wird eine solche Technik später in einem Kundenprojekt gebraucht, ist sie bei uns kein Neuland.

Warum das zählt

Wir testen zuerst an uns selbst.

Was das für ein Projekt mit uns bedeutet: Du bekommst Technik, die wir zuerst im eigenen Betrieb ausgehalten haben. Wenn wir sagen, dass ein selbstbetriebener Dienst wartbar ist, dann deshalb, weil wir ihn seit Monaten selbst warten.

Grenzen

Was das Gezeigte nicht ist.

  • Die Plattform ist in Entwicklung: Es gibt noch keine Organisation im Betrieb und keinen Go-Live. Was wir zeigen können, ist Baufortschritt — kein System, das man heute buchen kann. Eigene Instanzen auf einem Server der Organisation oder im eigenen Haus sind als Betriebsarten festgelegt, aber noch nicht angeboten.
  • Tagio ist fertig gebaut, aber in keinem Store und bei keinem Kunden im Einsatz — ein Beleg dafür, wie wir bauen, kein Produkt, das man heute laden kann.
  • Der Zeiterfassungs-Kiosk ist eine Lite-Fassung ohne Backend und ohne Hardwareanbindung — ein Terminal als Baustein, kein Zeiterfassungssystem, das man heute einführen kann.
  • KI-Modelle im eigenen Umfeld sind bei uns Aufbau- und Erprobungsarbeit ohne Kundenauslieferung — keine lieferbare Leistung.
  • Eigene Projekte zeigen Fähigkeiten. Was produktiv läuft und benannt werden darf, steht mit seinem Einsatzbereich auf der Referenzseite — auch interne Dienste wie die Geoplattform. Werkzeuge nur für den eigenen Bedarf führen wir nicht als Referenzen.
  • Forschung heißt bei uns nicht Grundlagenforschung. Wir bauen keine eigenen Modellarchitekturen, sondern setzen vorhandene Modelle im eigenen Umfeld ein und passen sie an konkrete Aufgaben an.

Was schon produktiv läuft.

Vier Systeme mit Stand, Zahlen und Belegen — die fertige Seite dieser Arbeit.